En resumen
OpenAI publicó datos preliminares sobre agentes en investigación. Describen actividad, no productividad causal. Nuestra guía compara enero y agosto y propone registrar calidad, intervenciones y decisiones humanas.
El interés práctico de este caso está en cómo evaluar una herramienta que puede ejecutar muchas tareas mientras las personas revisan pocas de ellas. Contar ejecuciones es sencillo; demostrar que ayudaron requiere definir qué resultado se esperaba y cuánto trabajo hizo falta para aceptarlo. Un panel con más actividad no resuelve esas preguntas.
Qué permite afirmar el informe
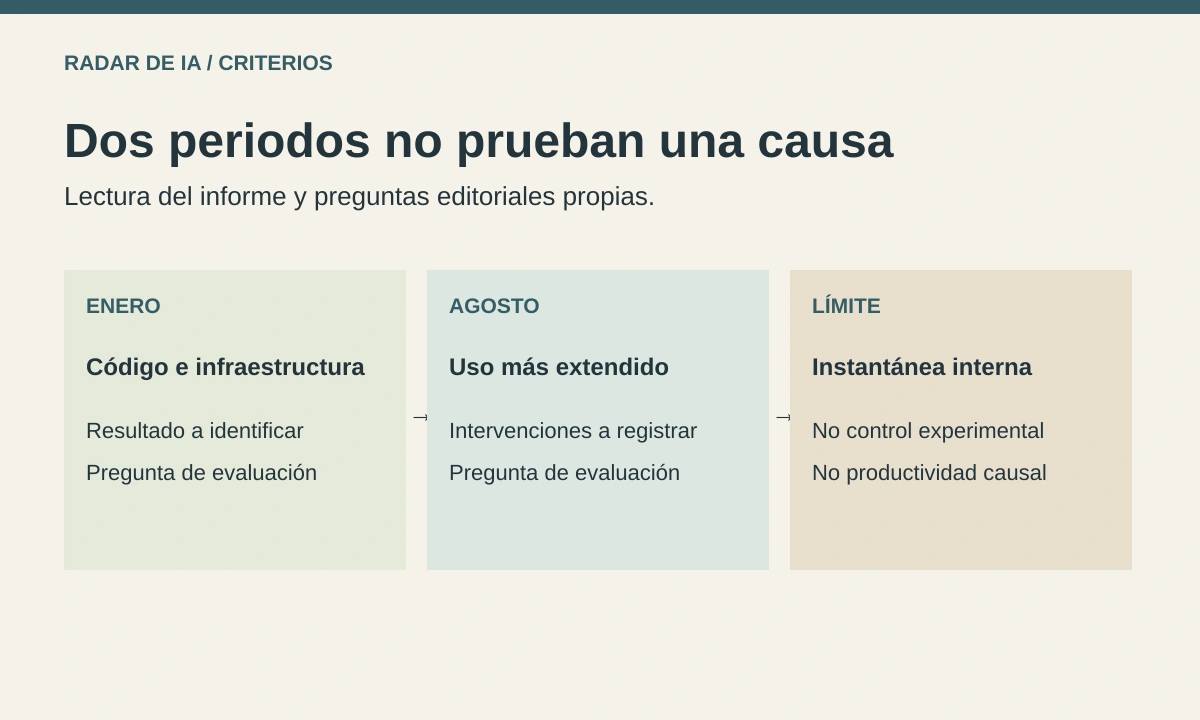
El informe de OpenAI del 6 de septiembre de 2026 presenta mediciones internas preliminares. En enero predominaban usos de programación e infraestructura; en agosto se ampliaron a asistencia técnica y seguimiento de ejecuciones. La empresa mantiene a las personas como responsables de prioridades, interpretación, escala, pausas y decisiones de despliegue. Su descripción de un asistente de investigación corresponde a tareas acotadas dirigidas por humanos, no a un investigador plenamente autónomo ya demostrado.
Una cifra del informe equivale a 3,1 jornadas de agente de ocho horas por jornada humana, agregadas en agosto. No significa 3,1 veces más resultados humanos. La adopción coincidió con más experimentos, pero también aumentó el cómputo disponible: el informe no permite atribuir todo el cambio a los agentes.
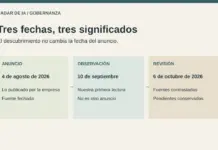
Fechas: publicación del 6/9/2026; primera observación de nuestra pauta el 10/9/2026; revisión de la fuente el 6/10/2026. Los datos describen una instantánea interna anterior, no una auditoría de nuestro equipo ni una garantía de resultados para otras organizaciones.
Enero y agosto: leer el cambio con límites
Esta tabla organiza el relato de la fuente y añade una pregunta propia de evaluación. No combina periodos como si fueran un experimento controlado ni convierte el volumen de actividad en calidad.
| Periodo descrito | Uso destacado por OpenAI | Pregunta propia |
|---|---|---|
| Enero de 2026 | Uso más modesto, centrado en código e infraestructura | ¿Cuál era el resultado aceptado de una tarea comparable? |
| Agosto de 2026 | Uso más extendido, también en ayuda técnica y seguimiento | ¿Cuántas intervenciones y correcciones necesitó cada resultado? |
Una ficha propia para evaluar una tarea
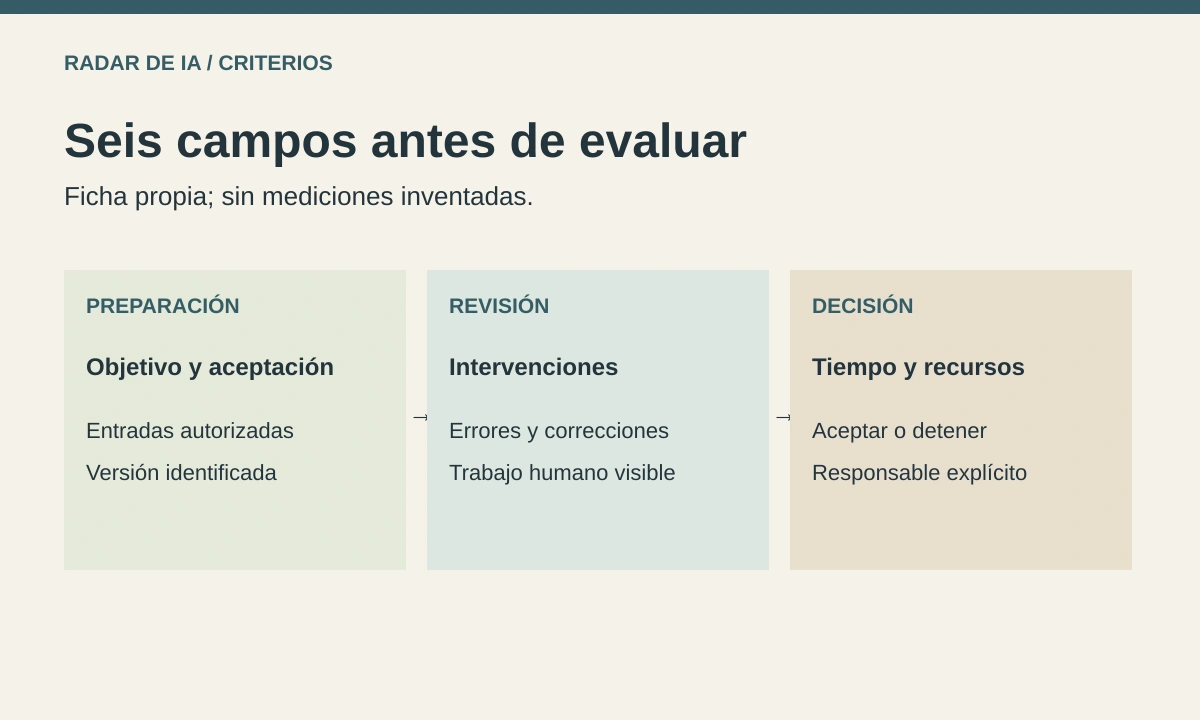
Proponemos guardar seis campos antes de una prueba pequeña con material ficticio o autorizado. Aquí no ejecutamos agentes, experimentos científicos ni llamadas a modelos; no contamos con una línea de base. La ficha es un instrumento manual para quien decida evaluar un flujo posteriormente.
| Campo | Qué registrar | Para qué sirve |
|---|---|---|
| Objetivo | Resultado esperado y condición de aceptación | Evitar llamar éxito a cualquier salida |
| Entradas | Material autorizado y versión | Comparar tareas con contexto conocido |
| Intervenciones | Momento, motivo y cambio realizado | Hacer visible el trabajo humano |
| Revisión | Error encontrado y corrección necesaria | Separar velocidad de calidad |
| Recursos | Tiempo humano y consumo documentado | Evitar equivalencias inventadas |
| Decisión | Aceptar, repetir, descartar o detener | Conservar una responsabilidad explícita |
Cinco puntos de intervención humana
1. Delimitar antes de iniciar
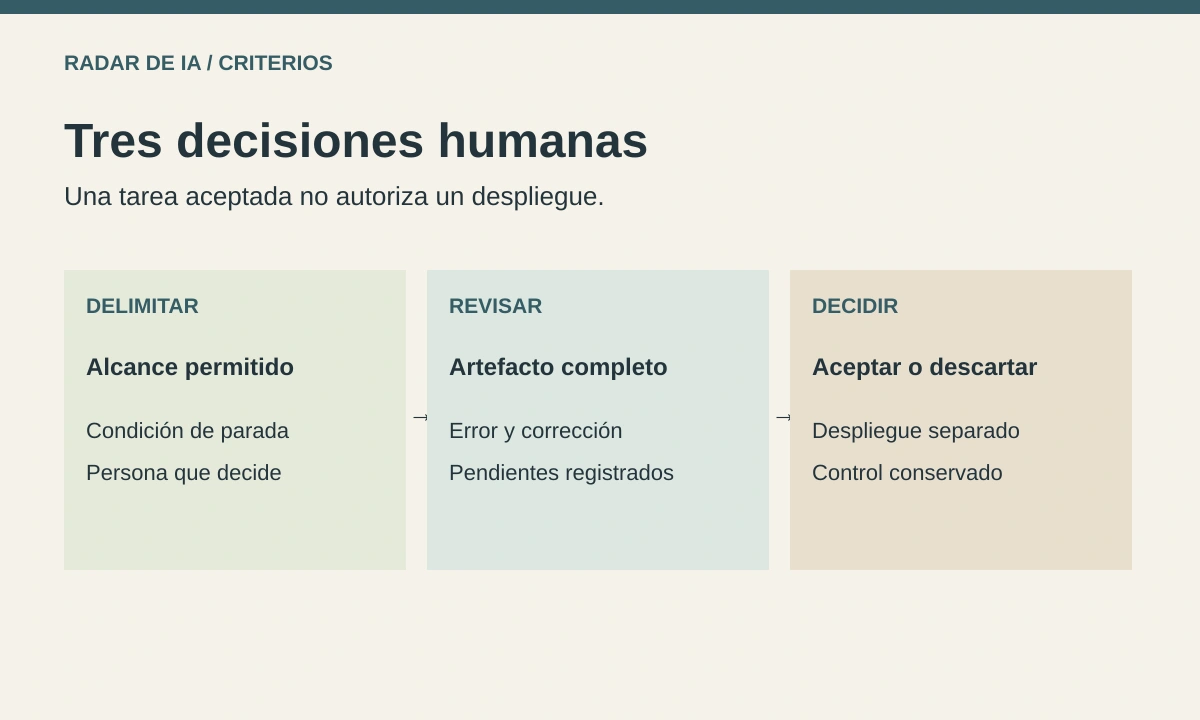
Especifique qué está permitido y qué queda fuera. Defina quién puede aclarar una ambigüedad y cuál es la condición de parada. Un objetivo amplio sin criterio de aceptación hace difícil distinguir una exploración útil de actividad sin dirección.
2. Registrar la primera desviación
Si la tarea requiere una corrección, anote su causa en lugar de ocultarla dentro de un resultado final. Distinga un cambio de instrucciones de la solución de un fallo. Así podrá explicar qué parte de la aparente autonomía dependió de ayuda.
3. Revisar el resultado completo
Compruebe las partes relevantes del artefacto, no solo su presentación. Una respuesta que parece terminada puede contener supuestos sin fuente. Registre también resultados desconocidos o no evaluados, sin contarlos como éxitos.
4. Separar aceptación de despliegue
Aceptar una tarea pequeña no autoriza por sí mismo publicar, ampliar recursos o modificar un sistema real. Mantenga una decisión humana específica para el siguiente paso y documente el motivo. El ensayo debe poder detenerse sin perder el trabajo revisado.
5. Comparar sin cambiar todas las variables
Cuando exista una línea de base real, utilice tareas y criterios comparables. Si cambia el material, la capacidad disponible o el proceso de revisión, registre esa diferencia. Una comparación honesta puede dejar una conclusión abierta en lugar de producir un porcentaje atractivo.
Cómo evaluar esta guía
Con datos propios posteriores y un periodo definido, podrían observarse consultas a las fuentes y uso de la ficha. Esos indicadores editoriales no prueban velocidad de investigación. No instalamos seguimiento ni una rutina programada y no afirmamos mejoras medidas. La utilidad del método dependerá de registros verificables, incluyendo fallos y trabajo humano, en cada contexto.
Lecturas relacionadas: cómo leer una promesa de velocidad de API y criterios para propuestas de investigación. La velocidad del servicio y la calidad de un proyecto son preguntas diferentes.
Recibe Radar de IA todos los días
Las noticias de inteligencia artificial que importan — con nuestro prisma y siempre con las fuentes. Gratis.