Lambda está usando switches con óptica coempaquetada (CPO) de NVIDIA Photonics para conectar racks NVIDIA GB300 NVL72 con más de 10 mil GPUs en una AI factory. Según NVIDIA, en las pruebas del proveedor la latencia de red cayó cerca del 4% a escala de rack y hasta cerca del 10% a escala de pod, con el mismo caudal de la óptica enchufable convencional. NVIDIA afirma además que la tecnología entrega hasta 5 veces más eficiencia energética y hasta 15 veces más confiabilidad que los transceptores enchufables, además de usar 4 veces menos láseres.
Lambda está usando switches con óptica coempaquetada (CPO) de NVIDIA Photonics para conectar racks NVIDIA GB300 NVL72 con más de 10 mil GPUs en una AI factory. La información es de NVIDIA, que publicó el caso en su blog y atribuye al proveedor de nube la decisión de adoptar la tecnología a escala.
El argumento central es simple: entrenar un modelo de IA exige que miles de GPUs trabajen juntas, y eso depende de una red rápida, eficiente y resiliente. Según NVIDIA, Lambda está atacando justamente la parte de red de ese rompecabezas.
Qué cambia con la óptica coempaquetada
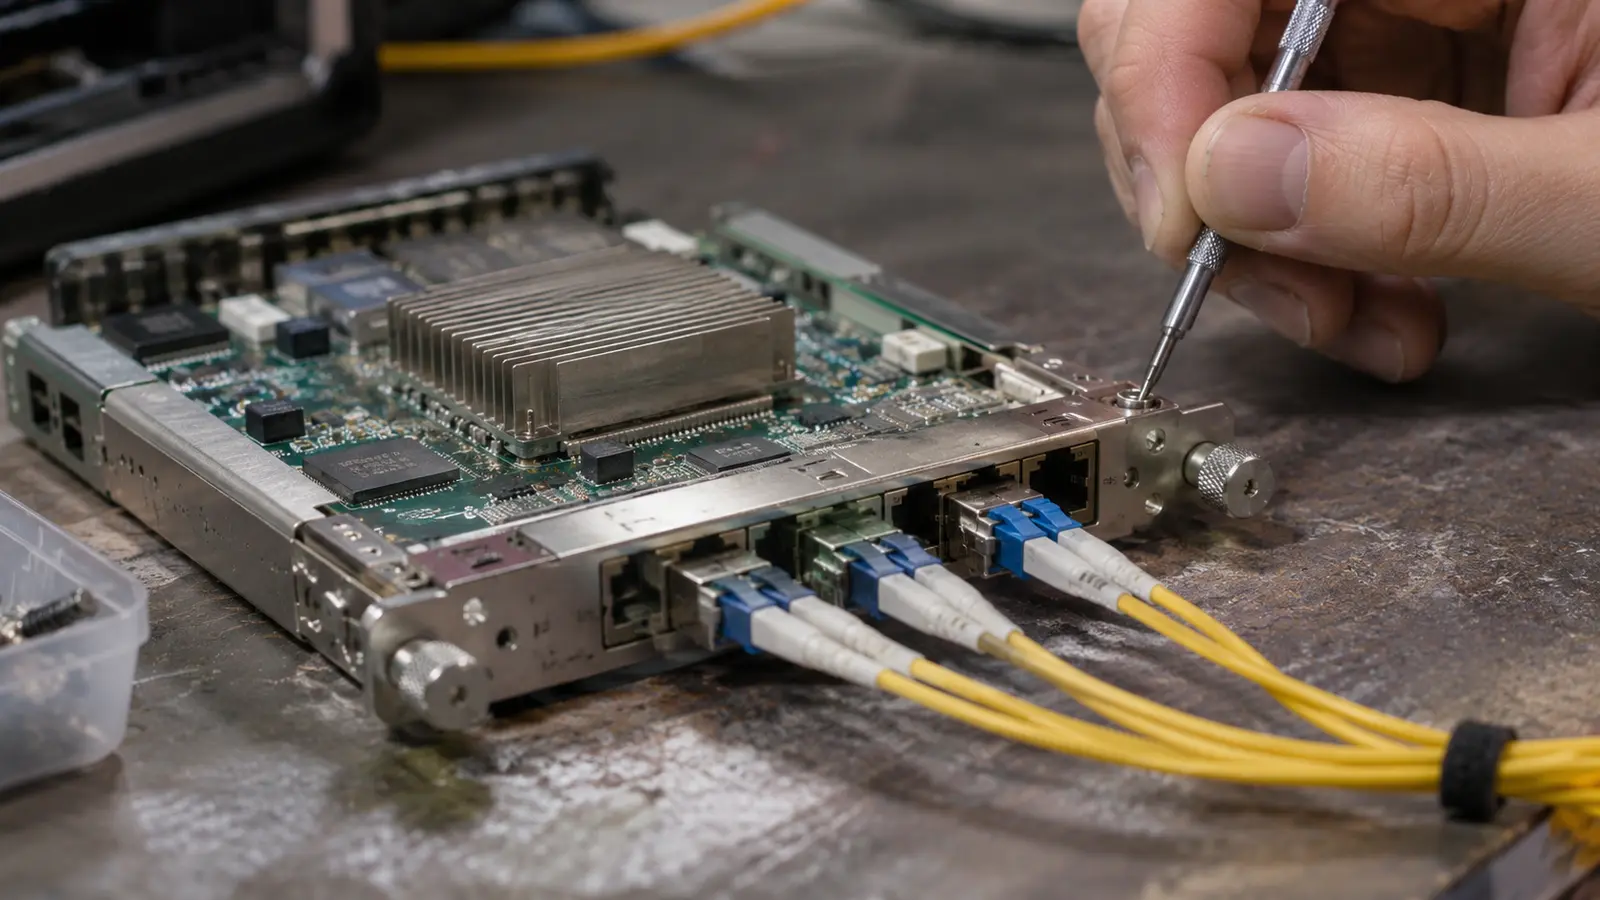
En el enfoque tradicional, los transceptores ópticos son enchufables y quedan separados del chip del switch. Con la CPO, los motores ópticos quedan en el mismo paquete del chip, lo que acorta el camino eléctrico de pulgadas a milímetros, reduce la pérdida de señal y elimina la necesidad de chips de retimer, recortando consumo y número de componentes en el camino de la señal.
NVIDIA afirma que, al sustituir transceptores enchufables por motores ópticos coempaquetados en el paquete del switch, la tecnología entrega hasta 5 veces más eficiencia energética y hasta 15 veces más confiabilidad que la óptica enchufable convencional. La empresa también dice que el diseño usa 4 veces menos láseres, lo que significa menos componentes sujetos a falla.
Cada switch usado por Lambda tiene 144 puertos a 800Gb/s, según NVIDIA. El enfriamiento es líquido y lleva el calor lejos del chip del switch y de los motores ópticos.
Latencia, temperatura y mantenimiento en campo
En las pruebas de Lambda con los switches, reportadas por NVIDIA, la latencia de red cayó cerca del 4% a escala de rack y hasta cerca del 10% a escala de pod. En configuraciones de rack, unidad escalable y pod, la red mantuvo el mismo caudal que la óptica enchufable convencional, de acuerdo con la publicación.
NVIDIA informa que Lambda reportó temperatura mediana de la óptica de 36°C, frente a 51°C en la óptica enchufable convencional, y que las pruebas encontraron integridad de señal más estable. La publicación no detalla la metodología completa de esas mediciones ni el período exacto de recolección.
Otro punto destacado es el mantenimiento. Cada switch tiene 18 fuentes de luz externas removibles, que alimentan los motores ópticos. Los técnicos pueden cambiar los módulos de fuente de luz en campo, a diferencia de la óptica enchufable tradicional, en la que la falla de un láser exige la sustitución del módulo entero.
NVIDIA sostiene que la eficiencia energética y la resiliencia importan porque la red está en el centro de la productividad de una AI factory. En un gran job de entrenamiento, un solo enlace interrumpido puede bloquear miles de GPUs. En inferencia agéntica, una interrupción de red puede generar efectos en cascada de latencia en muchos agentes. Cada interrupción cuesta tiempo, y cada vatio gastado en red es un vatio que no sobra para cómputo.
Lo que aún no está claro
Las cifras divulgadas provienen de NVIDIA y de la propia Lambda, sin detalle público, en el material proporcionado, sobre la configuración completa de las pruebas, el tamaño exacto de los pods o las condiciones de carga en que se hicieron las mediciones. Las ganancias de latencia de cerca del 4% y hasta cerca del 10% se presentan como resultados de las pruebas de Lambda, no como benchmark independiente.
Tampoco hay, en el texto de NVIDIA, información sobre costo de implementación, plazo de disponibilidad comercial amplia o comparación con otros enfoques de red para clústeres de IA. La declaración de Dave Ward, presidente de servicios de nube de Lambda, resume la apuesta: según él, la red debe acompañar la demanda de clústeres de IA cada vez más grandes, y llevar óptica coempaquetada a un deployment de esa escala es un paso importante para la infraestructura de la próxima generación de IA.
Para quienes siguen la infraestructura de IA, el caso señala una disputa que va más allá de las GPUs: la red pasa a ser tratada como parte crítica del rendimiento y de la disponibilidad de una AI factory, con impacto directo en consumo de energía y en tiempo de operación.
Fuente original: NVIDIA — Lambda Boosts AI Factory Resiliency and Efficiency With NVIDIA Photonics.
Recibe Radar de IA todos los días
Las noticias de inteligencia artificial que importan — con nuestro prisma y siempre con las fuentes. Gratis.