En resumen
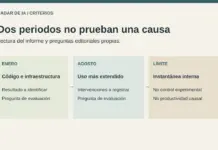
El artículo del 1 de julio describía la separación de robots de búsqueda, entrenamiento y agentes como una presión técnica y comercial. Una actualización del 30 de septiembre aclara que Pay Per Use está en beta: no es una obligación automática para todos los sitios ni demuestra que todas las empresas de IA participen.
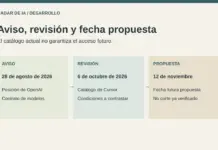
El artículo publicado el 1 de julio de 2026 describía un cambio en la forma en que los clientes de Cloudflare pueden controlar los robots que acceden a sus páginas. Según la noticia base de TechCrunch (IA), la compañía daba plazo hasta el 15 de septiembre para que las empresas de IA separaran los crawlers usados para búsqueda de aquellos usados para entrenamiento de modelos y agentes automatizados. Esa descripción pertenece al anuncio de julio; la beta de Pay Per Use tiene un alcance más acotado, como explica la actualización siguiente.
Actualización — 30 de septiembre de 2026. Cloudflare describe Pay Per Use como una beta: cada empresa de IA define qué uso paga y su precio; cada publisher revisa y acepta ofertas; Cloudflare registra los usos, factura al comprador y paga al publisher. No es una obligación automática para todos los sitios ni demuestra que todas las empresas de IA estén participando.
Fuentes oficiales: Anuncio oficial de Cloudflare — Pay Per Use · Documentación de AI Crawl Control · Documentación de crawlers y robots.txt
El cambio apunta a un punto central de la disputa entre medios de comunicación, plataformas digitales y laboratorios de IA: el contenido periodístico sigue siendo valioso para descubrir, resumir y entrenar sistemas, pero buena parte de ese uso ocurre sin compensación directa a los productores originales. Al exigir una identificación más granular de los robots, Cloudflare intenta impedir que una empresa use el permiso concedido para la indexación en motores de búsqueda como puerta de entrada para otros usos, como alimentar modelos o ejecutar agentes que recopilan información de forma masiva.
Qué cambia en la práctica
Hoy, muchos sitios dependen de reglas relativamente amplias para permitir o bloquear bots. El problema es que la frontera entre búsqueda, asistentes de respuesta, entrenamiento de modelos y navegación automatizada se volvió menos clara. Un crawler puede servir para mostrar enlaces en un motor de búsqueda tradicional, pero otro puede recopilar la misma página para entrenar sistemas que después responden al usuario sin enviar tráfico al sitio original. Para los publishers, esa diferencia es económica: una cosa es ser encontrado; otra, que su contenido sea absorbido por productos que compiten por la atención del lector.
Con la nueva política, Cloudflare quiere que las empresas de IA declaren funciones distintas para sus robots. Esto permitiría a los propietarios de sitios elegir, por ejemplo, permitir un bot de búsqueda, pero negar el crawler usado para entrenamiento. También abre camino a negociaciones más específicas: un publisher puede aceptar acceso para indexación pública, exigir un contrato para uso en respuestas generadas por IA y bloquear agentes que automaticen la recopilación sin autorización.
- El artículo del 1 de julio describía un plazo hasta el 15 de septiembre para diferenciar crawlers por finalidad.
- Los publishers pueden usar controles de Cloudflare para permitir, bloquear o explorar cobros por crawler según la configuración disponible.
- La medida puede fortalecer negociaciones comerciales sobre licenciamiento de contenido, pero no crea un pago universal.
- La distinción entre búsqueda, entrenamiento y agentes ayuda a describir finalidades distintas; su aplicación depende de la política y del acuerdo concreto.
La disputa por el contenido en la era de los resúmenes
La iniciativa llega en un momento en que los publishers cuestionan si la web abierta está siendo reconfigurada sin un nuevo acuerdo económico. Durante décadas, el intercambio implícito era relativamente claro: los motores de búsqueda rastreaban páginas, mostraban enlaces y devolvían tráfico. Con herramientas de IA generativa, esa relación se volvió más tensa, porque las respuestas completas pueden reducir la necesidad de hacer clic en la fuente original. Para las empresas de medios, esto amenaza la publicidad, las suscripciones y la propia justificación financiera para producir reportajes originales.
Grandes empresas de IA ya comenzaron a cerrar acuerdos de licenciamiento con algunos grupos de medios, pero el mercado sigue siendo desigual. Los publishers más grandes tienen mayor capacidad de negociación; los medios más pequeños muchas veces dependen de herramientas técnicas para imponer límites. Cloudflare, al estar entre los principales intermediarios de infraestructura de la web, tiene una posición poco común: puede transformar una preferencia editorial o comercial en una regla técnica aplicada a una porción relevante del tráfico global.
Esa posición también vuelve sensible la política. Si Cloudflare bloquea bots de forma amplia, puede influir en qué servicios logran acceder a la web a escala. Para las empresas de IA, esto crea costos operativos y comerciales: tendrán que documentar mejor sus crawlers, respetar preferencias por finalidad y, en muchos casos, negociar acceso. Para los publishers, sin embargo, la medida se ve como una forma de recuperar control después de años en que la recopilación automatizada creció más rápido que los mecanismos de consentimiento.
Impacto para buscadores, agentes y entrenamiento
La separación entre tipos de crawler es especialmente importante porque la IA no usa la web de una sola manera. Hay bots que rastrean páginas para índices de búsqueda; sistemas que recopilan corpus para entrenar o actualizar modelos; y agentes que navegan en nombre de usuarios para responder preguntas, comparar precios, reservar servicios o completar tareas. Cada una de esas funciones tiene implicaciones diferentes para la privacidad, los derechos de autor, el tráfico y la carga en servidores.
En la práctica, la política puede acelerar la creación de una capa de gobernanza más detallada para la web. En lugar de una elección binaria entre permitir o negar robots, los sitios pueden pasar a operar con permisos por uso. Esto se acerca a una lógica de licenciamiento: quien quiere usar contenido para generar un producto comercial debe declarar la finalidad y aceptar límites. La cuestión abierta es si las empresas de IA se adherirán de forma consistente o intentarán eludir bloqueos con nuevos identificadores, alianzas indirectas o recopilación mediante terceros.
También hay efectos potenciales para los usuarios. Si muchos publishers bloquean crawlers de entrenamiento y agentes, algunas herramientas de IA pueden tener acceso más limitado a contenido reciente o de alta calidad. Por otro lado, si la medida lleva a acuerdos pagos más transparentes, parte de los ingresos generados por productos de IA puede volver a quienes producen información original. El equilibrio entre acceso abierto, innovación y remuneración será una de las disputas centrales del sector en los próximos años.
Presión regulatoria y comercial
La decisión de Cloudflare no reemplaza las leyes de derechos de autor ni resuelve, por sí sola, el conflicto sobre uso legítimo, scraping y entrenamiento de modelos. Pero crea una herramienta de mercado con consecuencias inmediatas. Mientras tribunales y reguladores discuten límites jurídicos, las empresas de infraestructura pueden imponer estándares técnicos que alteran el poder de negociación entre plataformas de IA y productores de contenido.
Para las empresas de IA, el mensaje es claro: la etapa de recopilación amplia y poco diferenciada se está volviendo más difícil. Para los publishers, el cambio ofrece una palanca concreta, aunque no elimina la dependencia del tráfico proveniente de búsqueda y plataformas. La fecha del 15 de septiembre pertenecía al anuncio de julio; no equivale a una obligación universal ni a una confirmación de participación de todas las empresas de IA. El punto operativo que permanece es que el acceso a la web no significa autorización irrestricta para cualquier uso.
TechCrunch (IA), fuente original de la noticia base, describe la política como un movimiento para empujar a las empresas de IA a pagar por el contenido de publishers. Esa formulación resume bien el sentido económico del cambio: Cloudflare no solo está filtrando bots; está ayudando a transformar permisos técnicos en instrumentos de negociación comercial.
Nuestro prisma
La medida importa porque desplaza parte de la disputa sobre IA y contenido del terreno abstracto a una regla operativa aplicable a gran escala. Si funciona, los publishers podrán diferenciar la visibilidad en búsqueda de la explotación comercial para entrenamiento y agentes. En la práctica, las empresas de IA tendrán que ser más transparentes sobre sus crawlers y enfrentar más negociaciones de licenciamiento. El riesgo es una web más fragmentada, en la que el acceso a información reciente dependa cada vez más de acuerdos privados entre infraestructura, plataformas y grandes productores de contenido.
Fuentes: TechCrunch (IA) · Cloudflare — Pay Per Use · AI Crawl Control
Preguntas frecuentes
¿Qué describía la política de Cloudflare?
El artículo del 1 de julio describía la separación de crawlers de búsqueda, entrenamiento y agentes. La actualización del 30 de septiembre añade que Pay Per Use está en beta y que su alcance depende de cada configuración y oferta.
¿Por qué esto afecta a los publishers?
Porque da a los sitios más control para permitir indexación en búsqueda, bloquear recopilación para entrenamiento o uso por agentes y, cuando corresponda, explorar acuerdos comerciales.
¿Las empresas de IA estarán obligadas a pagar?
No hay un cobro automático universal. Pay Per Use es una beta en la que cada empresa define qué uso paga y su precio, cada publisher revisa ofertas y la participación concreta debe verificarse.
Recibe Radar de IA todos los días
Las noticias de inteligencia artificial que importan — con nuestro prisma y siempre con las fuentes. Gratis.